Qwenシリーズは中国のAmazon的な企業であるAlibabaのAIモデルです。
- LLMのQwen
- 画像生成 Qwen Image
- 動画生成 Wan
- エージェントツールのQwen Code
一般的にはこれらのモデルは有名ではありませんが、自分のPCでAIモデルを動かすローカル勢にはAlibabaのモデルは超メジャーです。なぜならここはオープン化に積極的だから。
また、自転車パーツの海外通販でAlibaba系のグローバル向け通販サイトのAliExpressには10年前からいろいろ助けられるor悩まされます。

で、そういう腐れ縁でうちのエージェントはClaude CodeでもCodexでもOpencrawでもなく、Qwen Codeです。使い勝手はGemini系のCLIとほぼ一緒です。パクリ?
このAlibabaのQwenとGoogleのGemmaはローカルLLMの希望の星です。ユーザーのコミュニティーが非常に活発で、カスタムモデルや派生版がわんさか出ます。
2025年下半期にはQwen Imageのアップデートの構成が激烈でした。年末はあきらかにバグで、2511と2512の数字の通りに2025年11月と2025年12月にアップデート版が来た。しかも、特徴がちゃんと違った。
おかげでドット絵の作成が非常にはかどりました。これはぼくのQwen Imageの成果物です。
2512のドット絵の出来栄えが良好でして、お絵かきが捗りました。
このドット絵が3分くらいで生成されます。
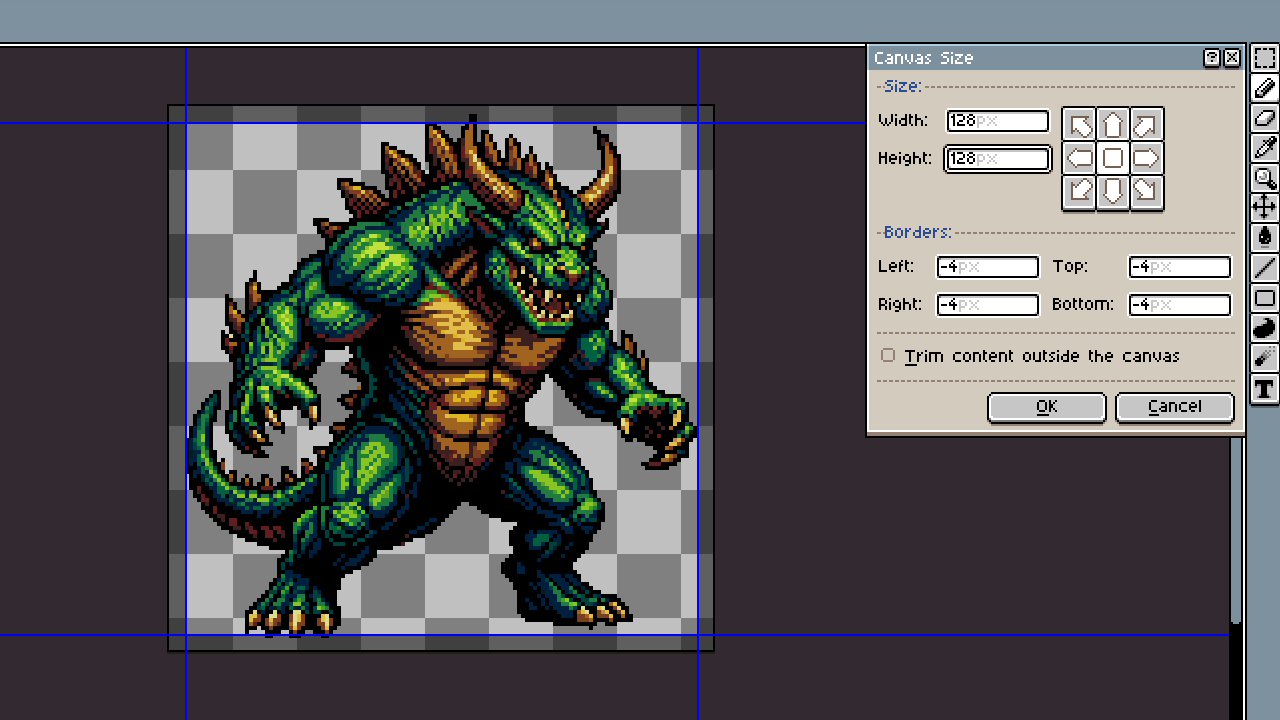
この画風がぼくの好みにばっちりハマりました。この春先についつい調子に乗って、RPGの敵グラを100体ほど作ってしまいました。
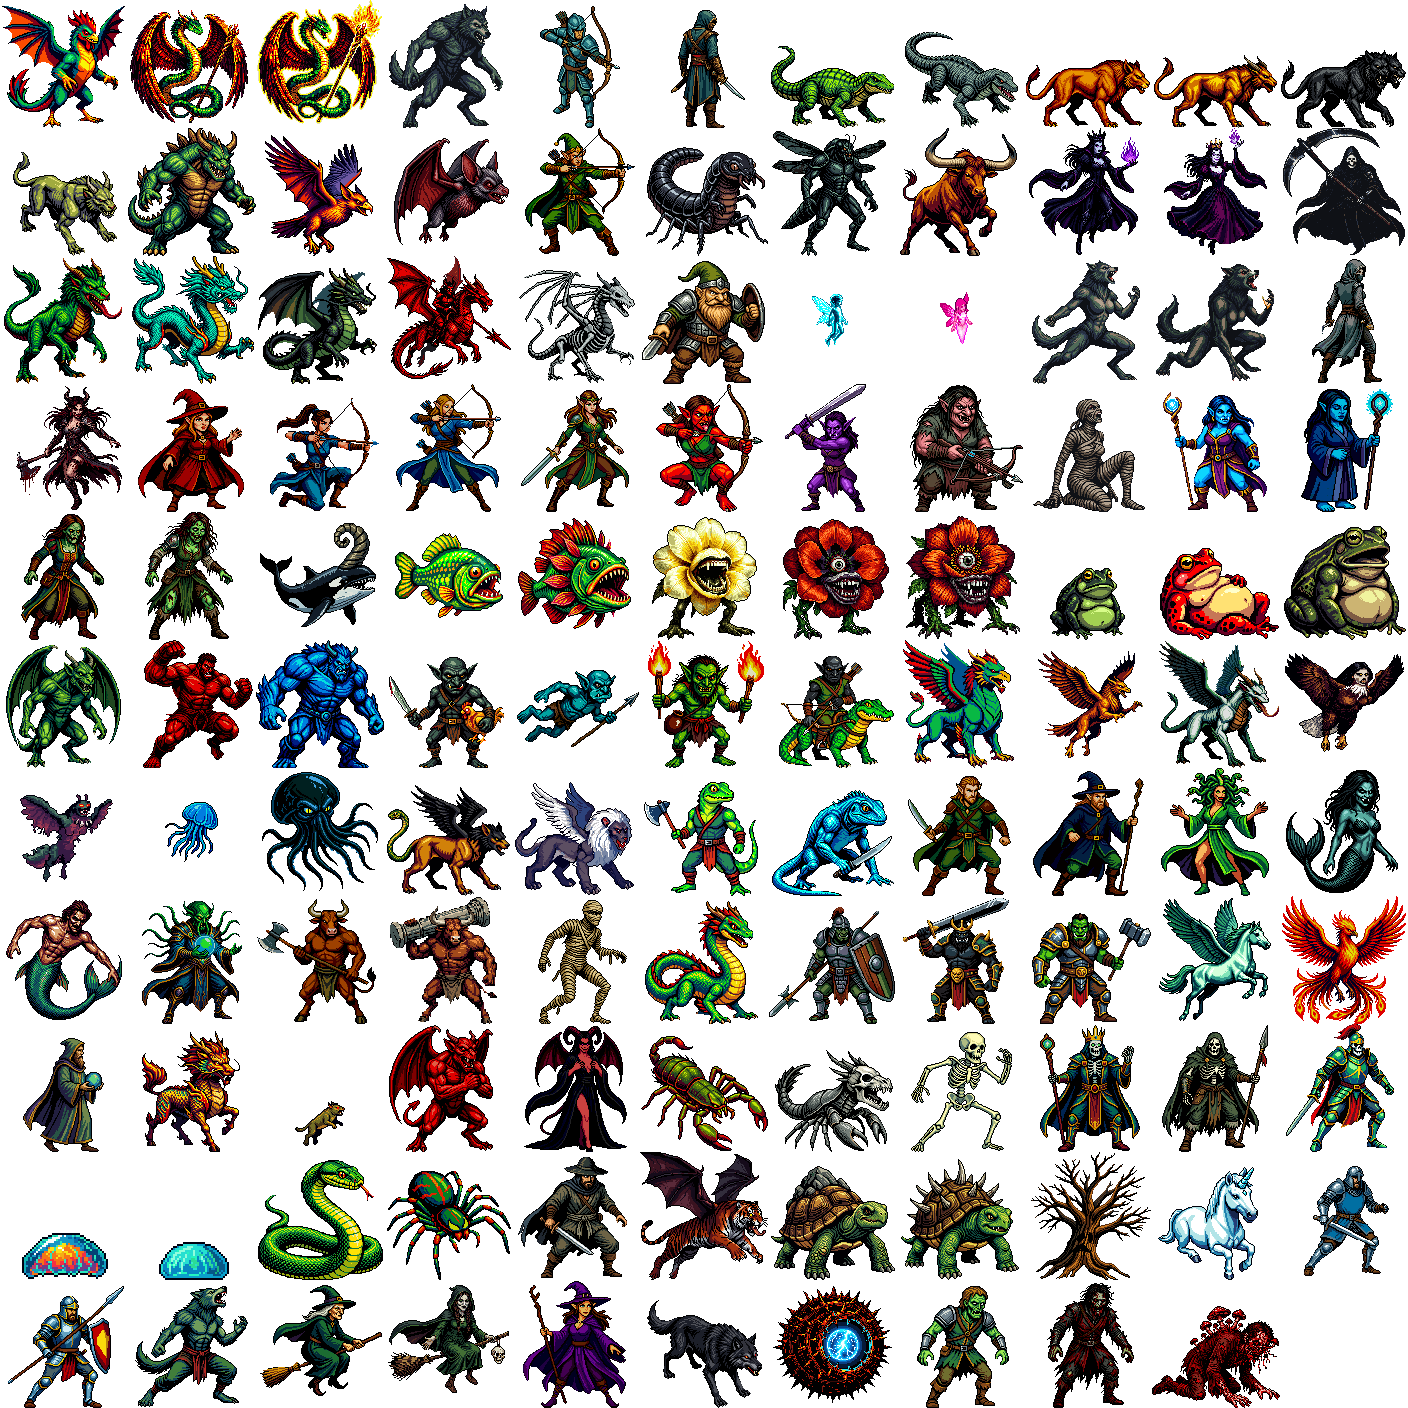
暇か。
しかしながら、この2512が出た後でAlibabaの方針が少し変わって、Qwen Imageの更新がパタッと止まりました。画像・動画部門のトップの人事異動があったとかなかったとか。
結果、LLMのQwenは3.5、3.6、3.8と順調に進化しましたが、Imageは2026年には全く沈黙でした。画像生成のオープンモデルはここで打ち切りだ?
この間に新興のKrea 2などが台頭して、Alibabaの画像モデルの印象がすこし後退しました。もっとも、2512と2511版は充分に優秀です。Apache2.0ですし。
が、ようやくこの9月20日にひさびさのアップデートがきました。待望の新モデル、それがQwen Image 2.1です。
Qwen Image 2.1の基本情報
Qwen Image 2.1の基本情報です。
| 比較項目 | Qwen-Image-2.1 (最新版) | Qwen-Image-2512 (前世代) |
|---|---|---|
| 公開時期 | 2026年9月20日 | 2025年12月 |
| 主な役割 | 画像生成 + 画像編集 + 複数画像合成 | 画像生成(Text-to-Image)特化 |
| モデル構造 | Single-Stream DiT (7B) ※生成と編集のアーキテクチャを一本化 | 生成専用の独立したDiT構造 ※編集には別モデル(Edit-2511等)が必要 |
| 動作軽量さ (VRAM) | 極めて軽量 (Q8量子化で約7.1GB) VRAM 10GB〜12GB環境で快適に動作 | 比較的重い (Q5量子化でも約13.9GB) フルスペック動作にはVRAM 16GB以上を推奨 |
| 透過画像対応 | ネイティブ対応 (RGBA) 背景透過の素材をそのまま生成・維持可能 | 非対応 (RGBのみ) 背景を透過させるには外部ツールでの切り抜きが必要 |
| 複数画像の参照 | 最大10枚の画像を入力可能 人物の顔や服、家具を維持した合成が可能 | 基本非対応 (プロンプトによるテキスト指示が中心) |
| 日本語・文字描写 | 向上(フォントの雰囲気や正確性が改善) | 対応しているが、時折文字の崩れが発生 |
| 画風・生成傾向 | 空気感や光の表現が繊細、人物のバリエーションが豊富 | コントラストが強くはっきりした描写、やや画一的な顔立ち |
必要なファイルはHugging Faceにあります。Comfyへの配置は以下の通りです。
- difusion_models :qwen_image_2.1_int8_convrot.safetensors
- text_encoders:qwen3vl_8b_int8_convrot.safetensors
- vae:qwen_image_2.1_vae_bf16.safetensors
bf16版はうちのRTX3090=24GBには収まらない? 5090用か? とにかくうちでは生成が成功しません。たぶん、メモリ不足です。
で、ここでは軽量版のitn8版を使います。
透過色に対応
Qwen Image 2.1の最大の進化は透過色の取り扱いです。Qwen2512含む2025年の画像生成モデルは基本的に透明色を扱えなかった。
実際、ぼくは上のドット絵の作成には画像ソフトやPythonのpilowで透過処理を入れて、背景の白をざっくり抜いて、あとから編集ソフトで細かいノイズをちまちま取りました。
新Qwen Imageは透明色を普通に扱えます。背景の抜きができる=画像のアセット化の手間が減少する。もっとも、ざっくり背景抜きはそこまで難しい工程ではありませんが。
うちの画像生成専用ツールでは
- 白背景指定
- 画像の左上の1ドットの色を判定
- 同色を範囲で消去
のような処理が自動で入ります。
2511の修正機能を統合
新規画像に強い2512
修正に強い2511
このように旧モデルの特徴が異なり、運用はニコイチ的でしたが、Qwen Imade 2.1はこれらを統合して、1モデルでいろいろできる汎用モデルとなりました。
ためしに既存の画像を参照し、”transparent background”のプロンプトを入れてみました。
左上のカエルがベースの画像です。見ての通りに白背景です。
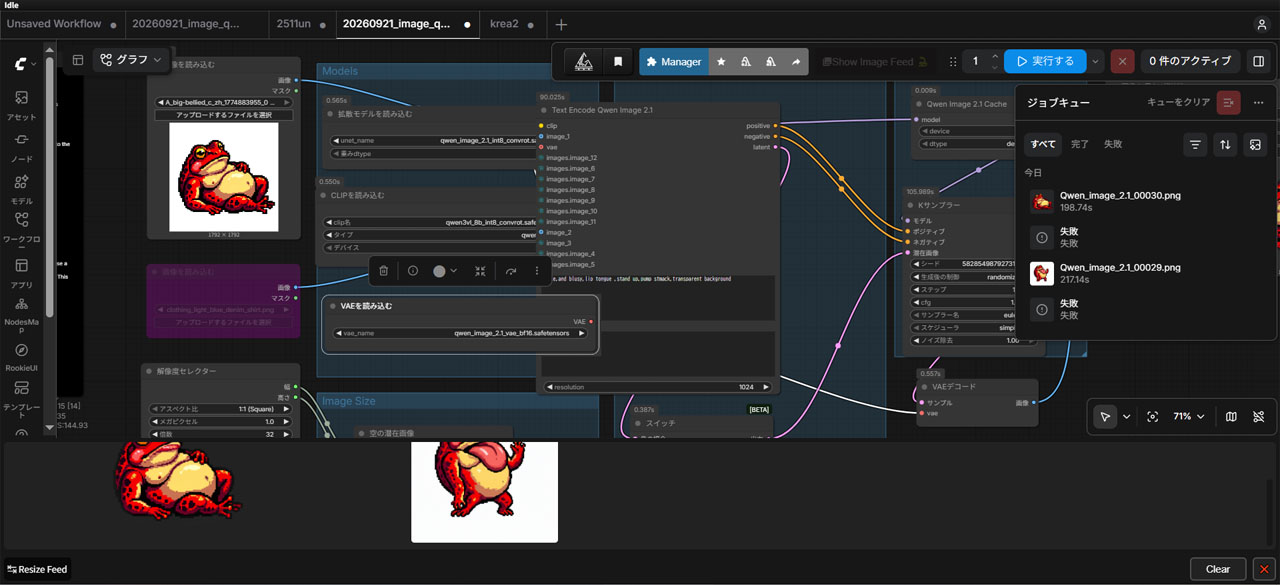
生成結果です。
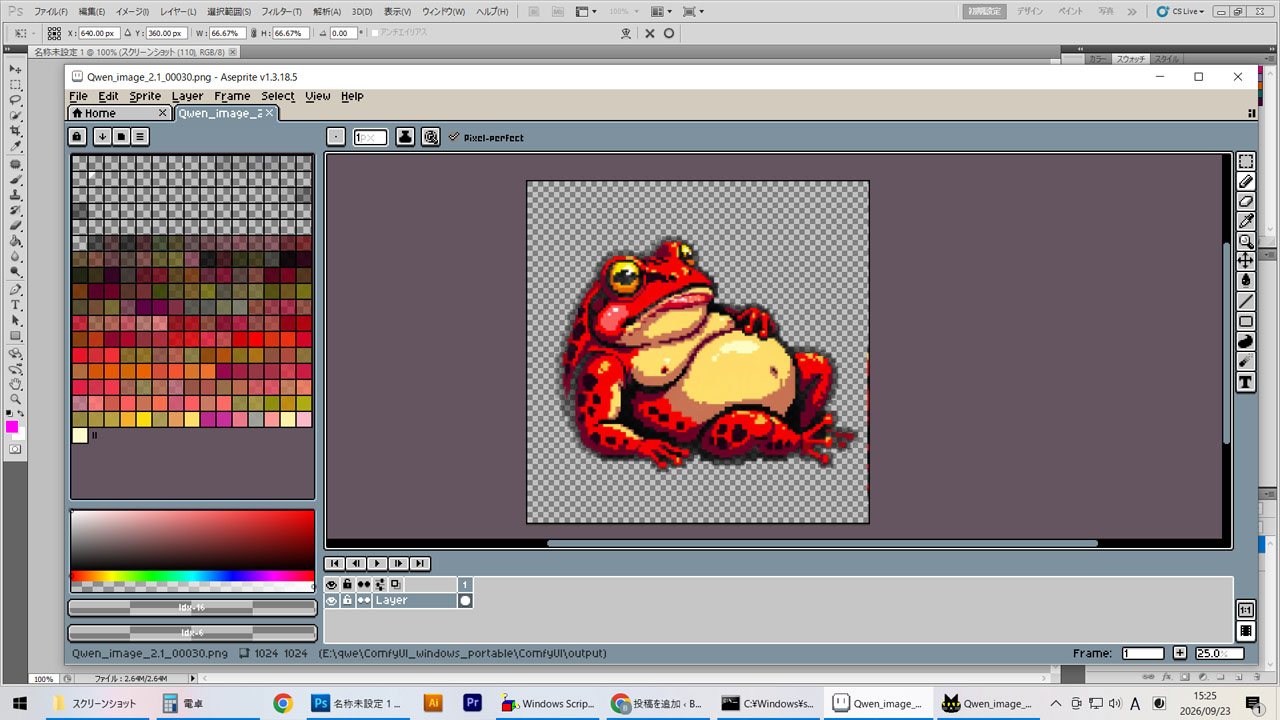
白の背景部分はほぼ完ぺきに透過色で切り抜かれました。ただし、実線の黒の輪郭線がぼやけます。そして、カラーのパレット数がけっこう増える。で、やっぱり、色数の指定はムリです。たぶん、ここは永遠に不可でしょう。
これはsmile,lip tongue ,stand up,pump stmachの修正結果です。
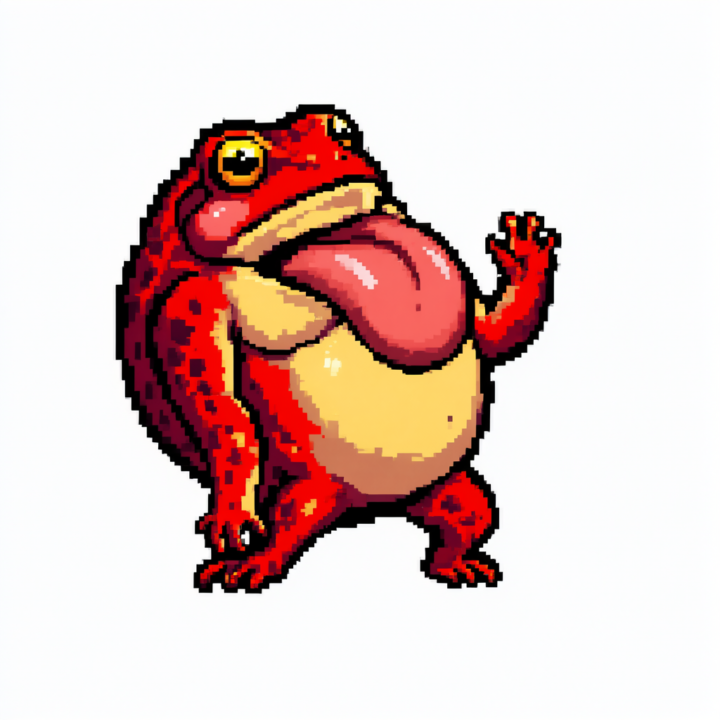
口の下からベロが出ました。あの黒い線が口と判定されなかったか・・・もっとも、ドット絵のモンスターは生成モデル的にはなかなかイレギュラーです。あと、カエルはそもそも二足で立たない。
と、1モデルでの機能が大幅にアップしました。生成と編集が切り換えなしで可能です。
Qwen Image 2.1の絵柄
さて、機能面の充実は個人的には特別なものではありません。完全なアセットはAIモデルでは完成しないので。
現状、色数の限定、画像の軽量化などはAIモデルでは不可です。photoshopやasepriteなどの画像編集ソフトでの最終仕上げは必須です。
で、ぼくの関心は『絵柄』となります。オーソドックスな女子の絵を出してみましょう。プロンプトは以下の通りです。
masterpiece, authentic details, legible drawing, no bad anatomy, no bad hands, no missing fingers, no extra fingers,hime-cut hair,slender body 18 years old girl,tops white jacket,bottom black trouser,on grass,background street in tokyo,close up shotこれの出力です。
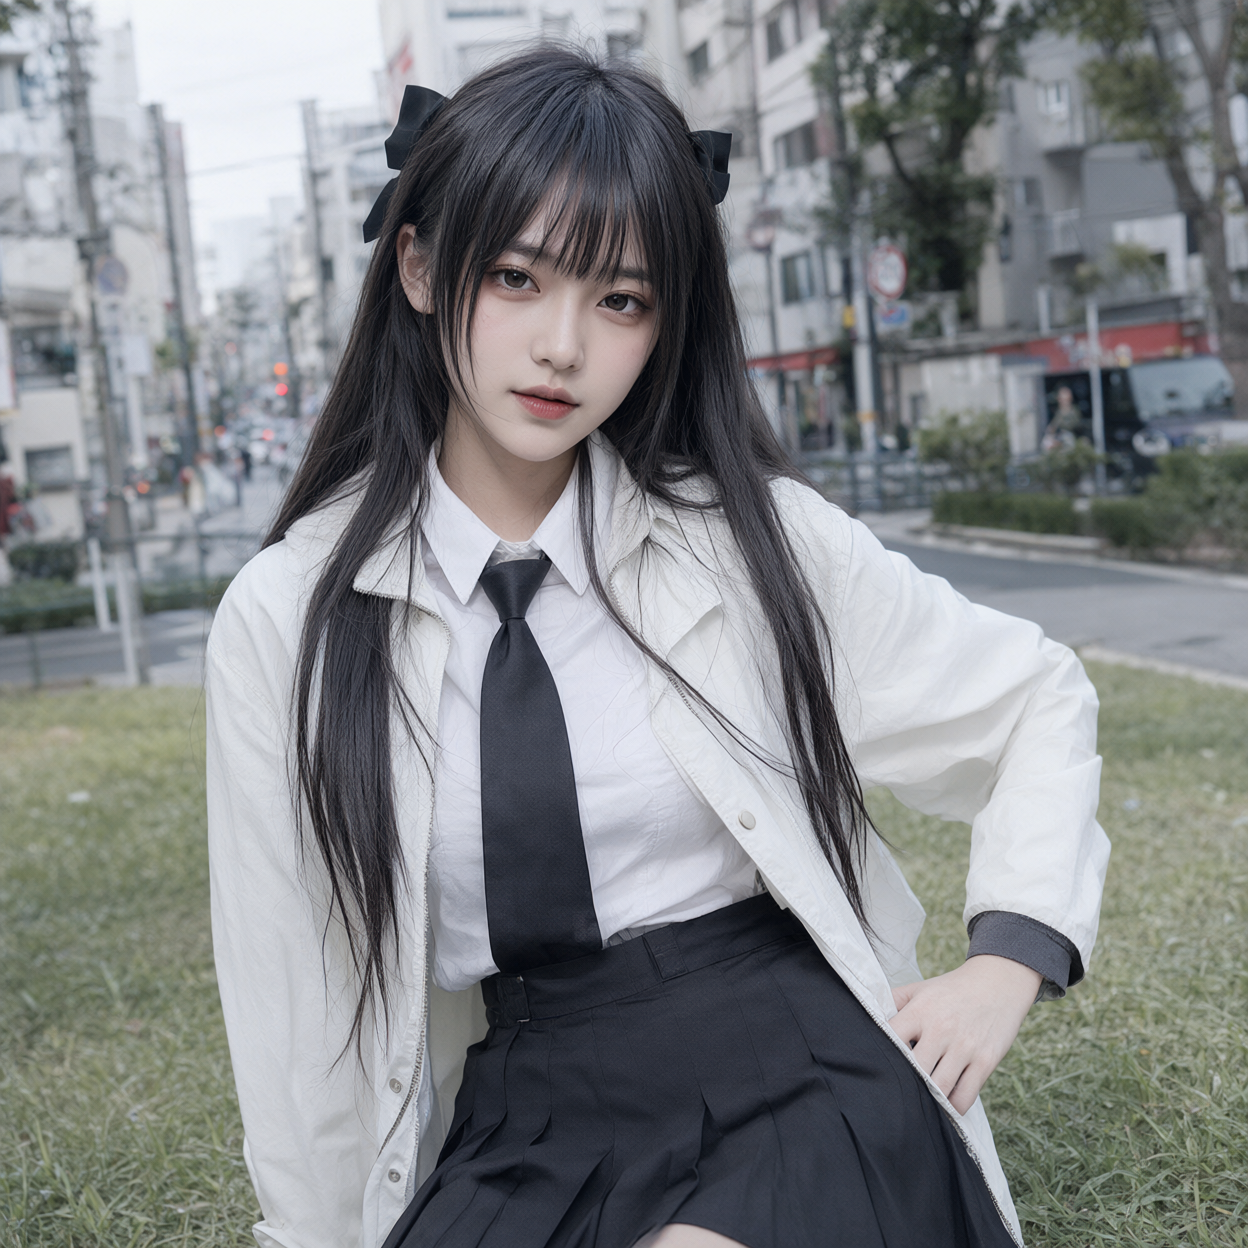
日本韓国風のSNS的美人が出てきました。背景もまあまあ日本ぽいですね。服が安いコスプレっぽくなるのはAI画像あるあるです。
生成時間は大きさ1248×1248のステップ24で224秒です。まあ、ふつうです。
おなじプロンプトに”rich anime character”を追加しました。
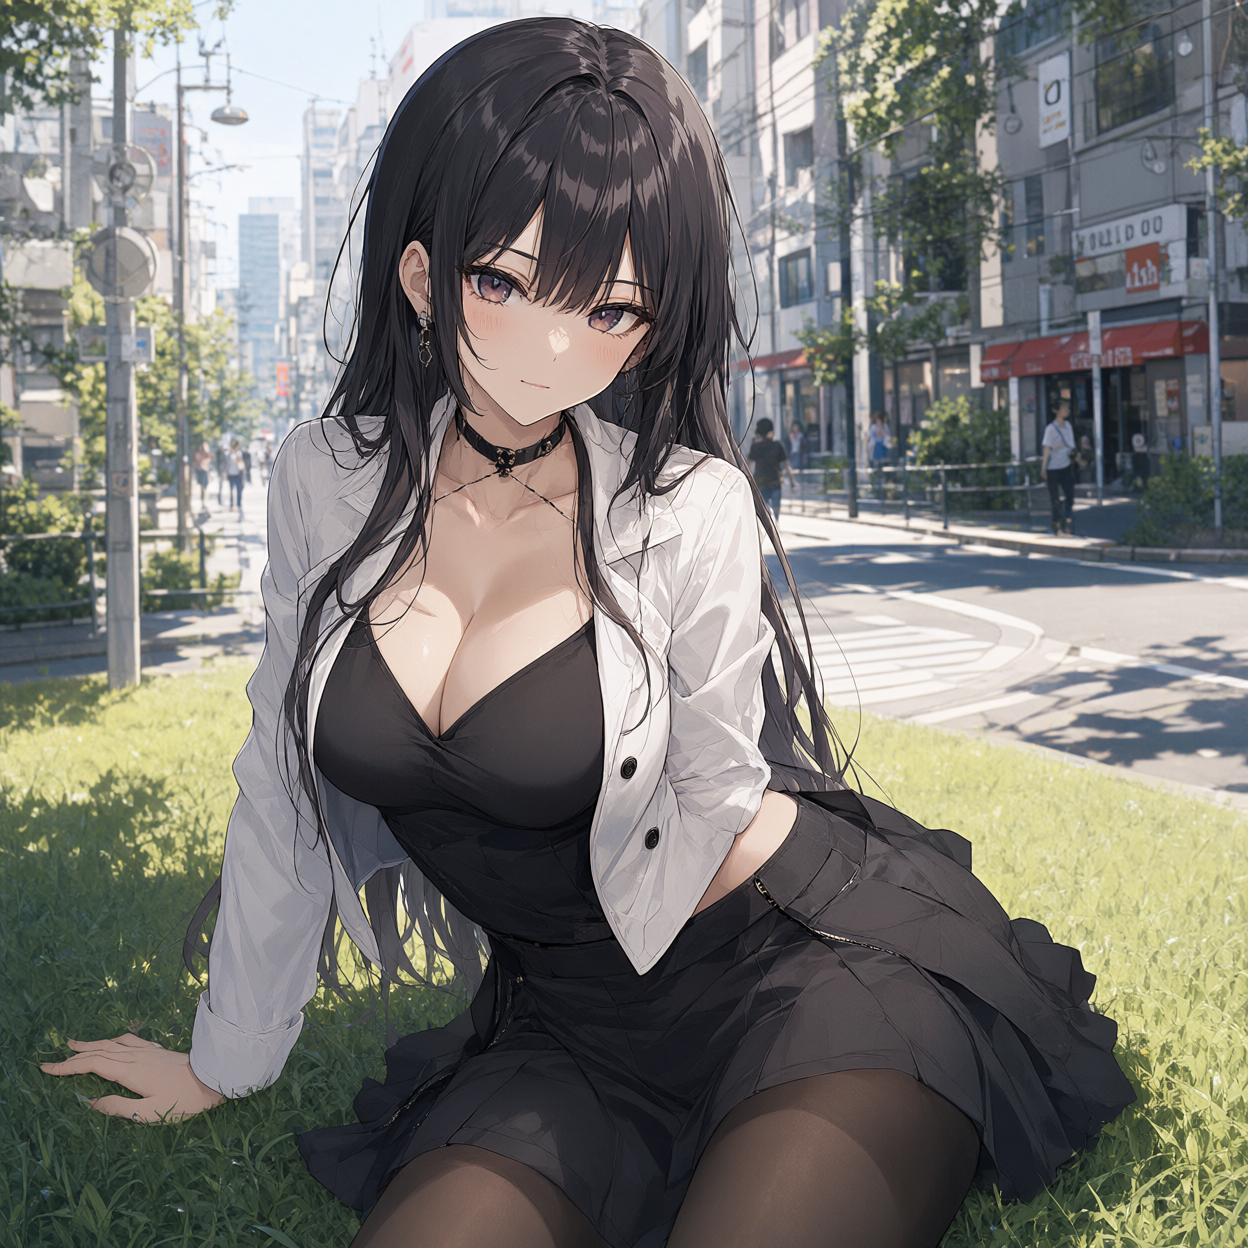
なぜか露出が急にふえます(そんな指定はないのに)が、描写はいかにもなアートスタイルぽいイラスト調です。ほんわりソフト。ラノベやソシャゲのアートスタイル風というかpixivぽいというか。
この絵柄はぼくの好みとはかなり乖離します。なんか全体のメリハリ感がない。あと、全くスレンダーボデーではない。が、イマドキスタンダードから大きく外れません。
ただ、2512もアニメ・イラスト画の描写は優秀ですから、目新しい手応えや変化は微温的です。特段のサプライズはない。
これは2512で作成した正面絵を2511でサイド絵にしたものです。ややフラットベクターより。
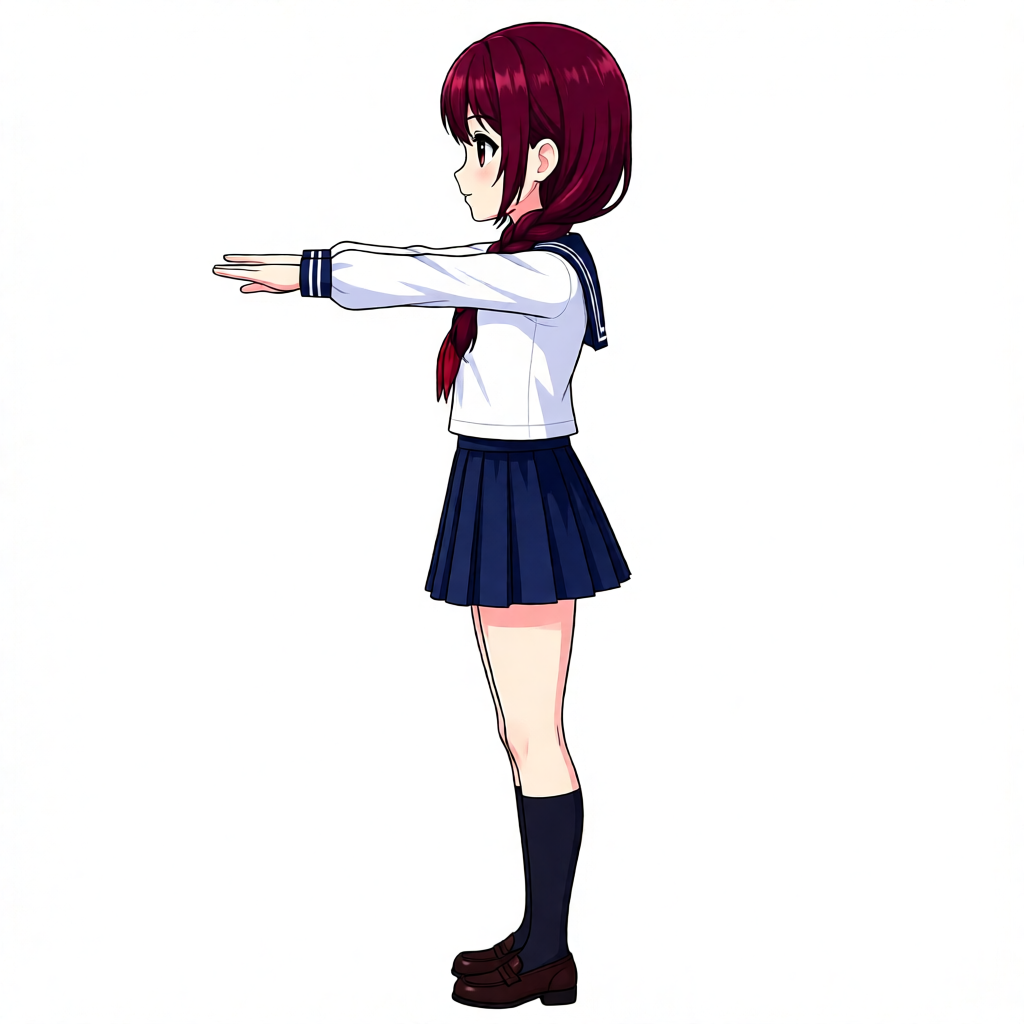
このちょいレトロなくっきりはっきり系の方が古参にはなじみます。
もちろん、2512でふんわり系の描写も可能です。ベースを2512で作り、表情変化のためのショート動画をwanで生成して、いいコマだけ切り抜いて、GIFアニメ化しました。
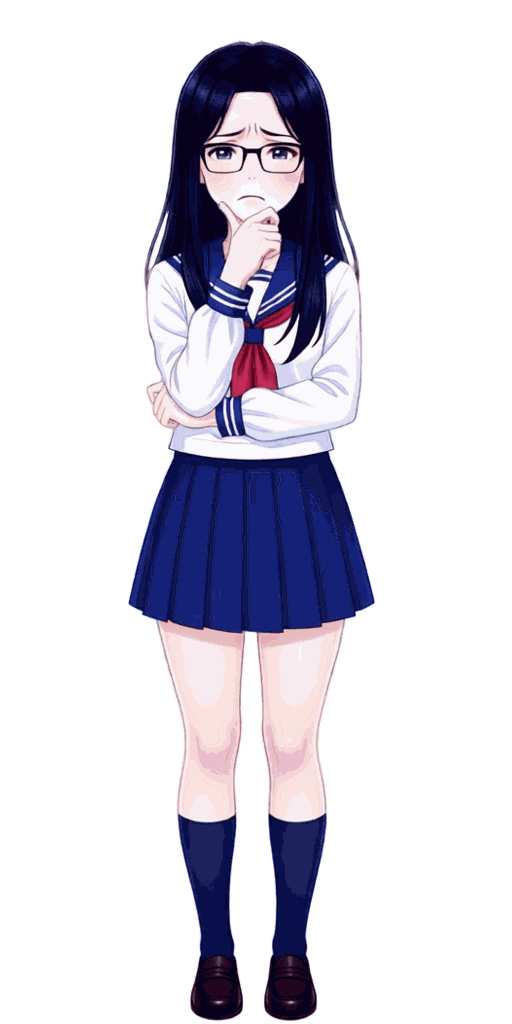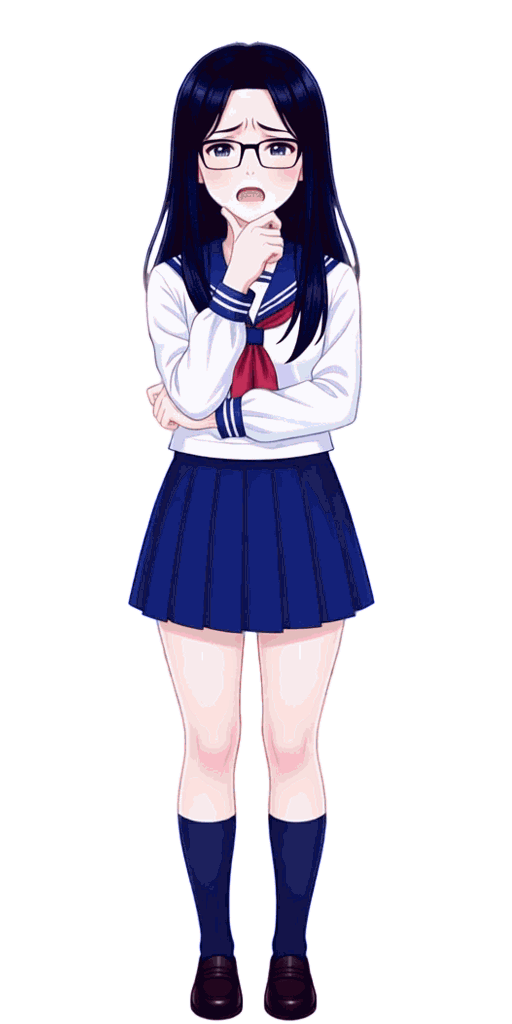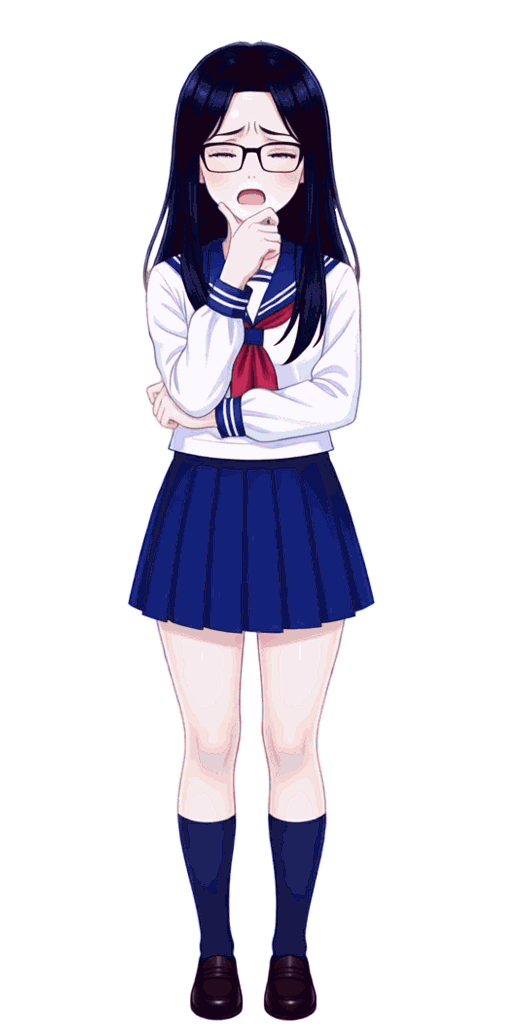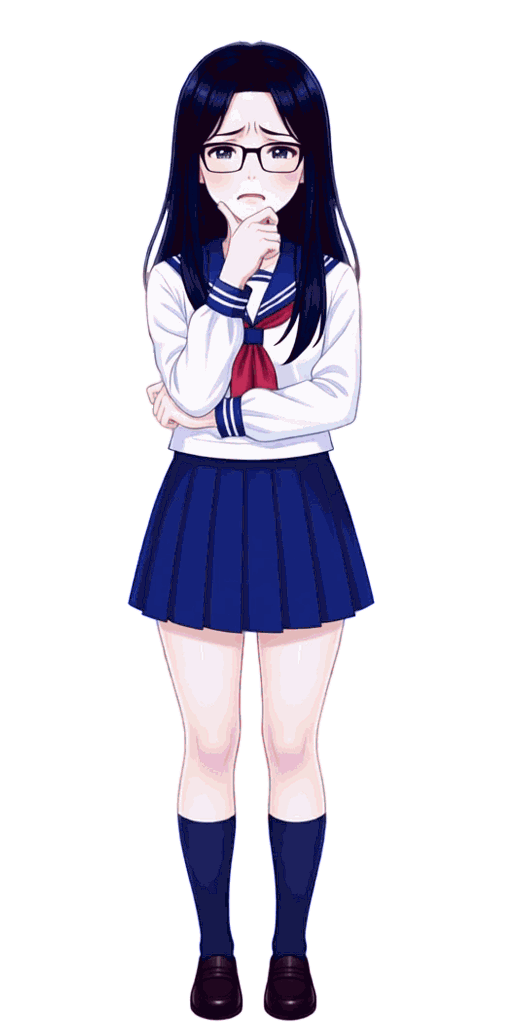
つまり、絵柄の劇的な変化はとくにありません。これは誤算だ。
そして、前髪の細部を見て、はっと息をのみます。
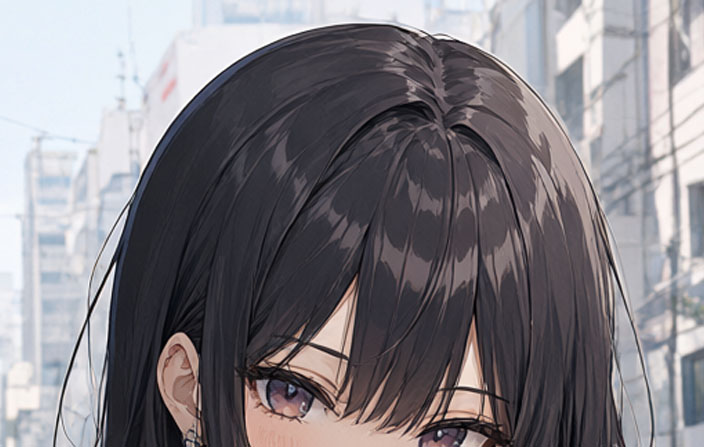
ぐわー! デジャブ!
なにって? この前髪の真ん中に細い髪のまとまり=『ノ』みたいなやつがありますよね? 逆アホ毛みたいなやつ。2512でこれを死ぬほど見た。トラウマ。止めて!
あと、長髪のサイドの髪の毛がふわっとばらけますが、これは切り抜きには地獄です。
画像をものすごくいっぱい生成すると、絵柄のバリエーション、細部のパターン化、マンネリに行き当たります。この前髪の房はQwen Imageって感じです。正味、食傷気味だ。
Krea2の方が・・・
上記のようにQwen Imaegaは2025年12月からこの9月までしばらく沈黙しました。その間にトレンドに躍り出たのがKrea2です。
これもQwen系の派生っぽい? 中華系のモデルです。
これがアニメ、イラスト調の絵の生成にはかなり良好です。しかも、1280×1280のステップ24が180秒くらいで出来上がります。
だいたいおなじプロンプトの生成物です。おまけで”suprised face”と”hat”を付けてみました。
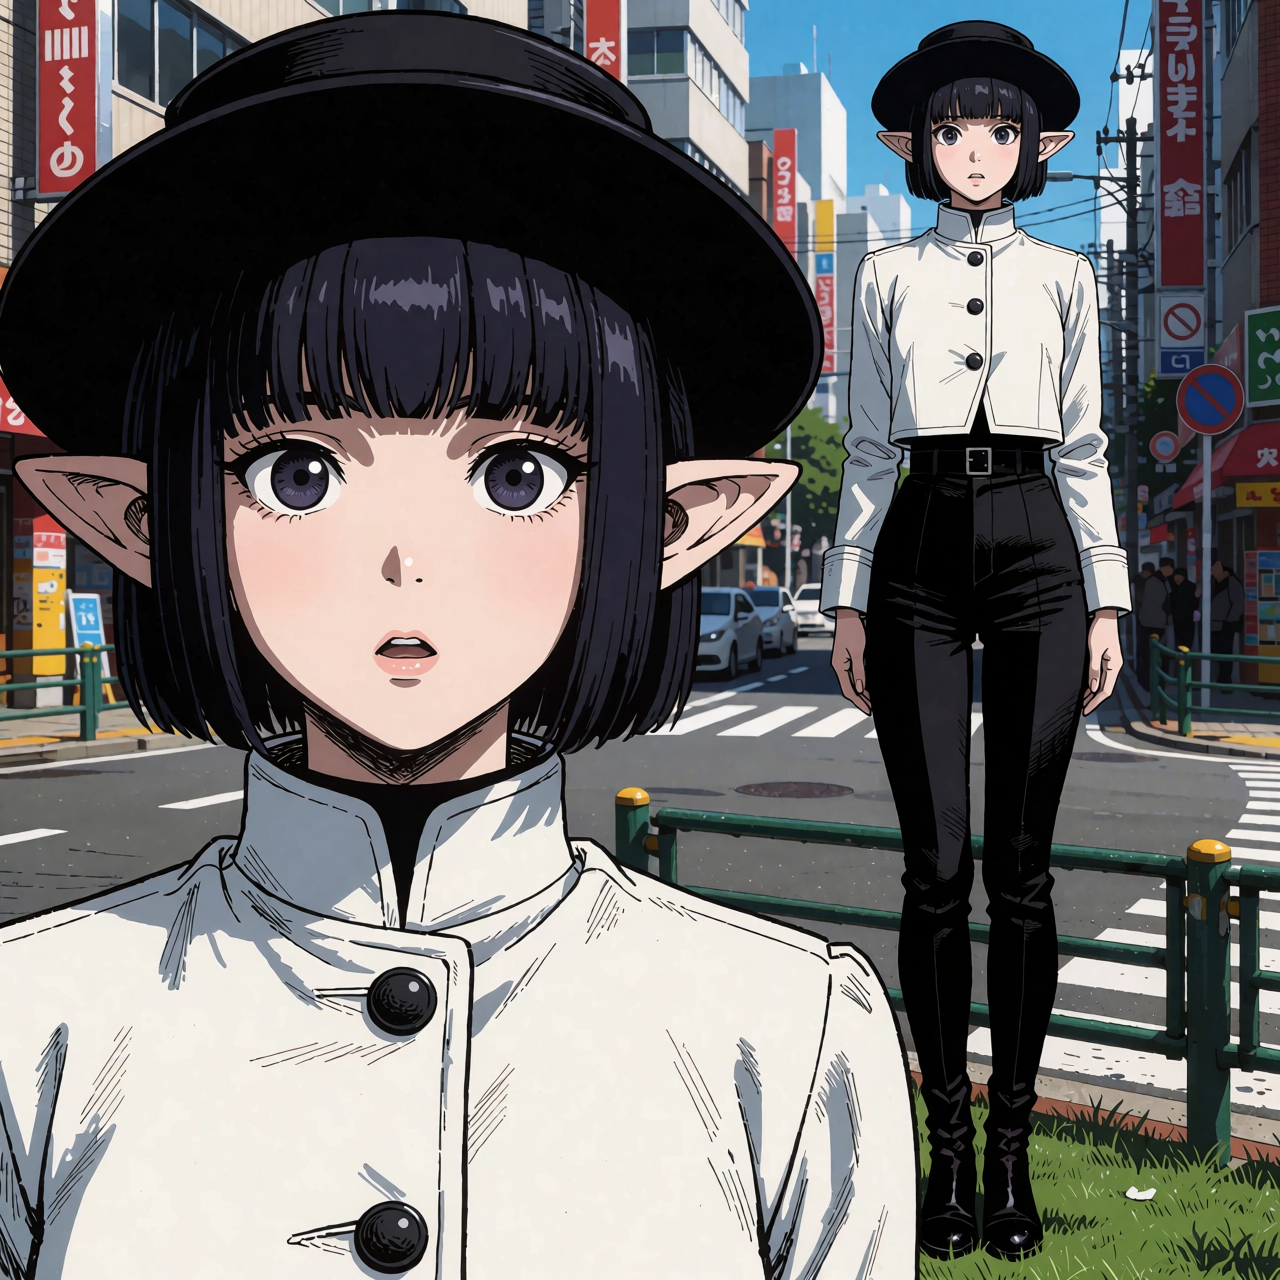
そうそうそう、このメリハリです。エルフ耳と看板がたまに瑕ですが、絵柄はドストライクだ。ちゃんとスレンダーですし。エルフ耳はフリーレンのせいです、たぶん。
難点は大きめの画像で人物がしばしば分身することです。空白を人物で埋める傾向。プロンプトでの指示が必須です。
ここで一つのアイディアが浮かびます。Krea2で生成して、Qwen 2.1で修正するのはどうだ?
これはKrea2の女子。ややソフトタッチなラノベ挿絵風絵柄。
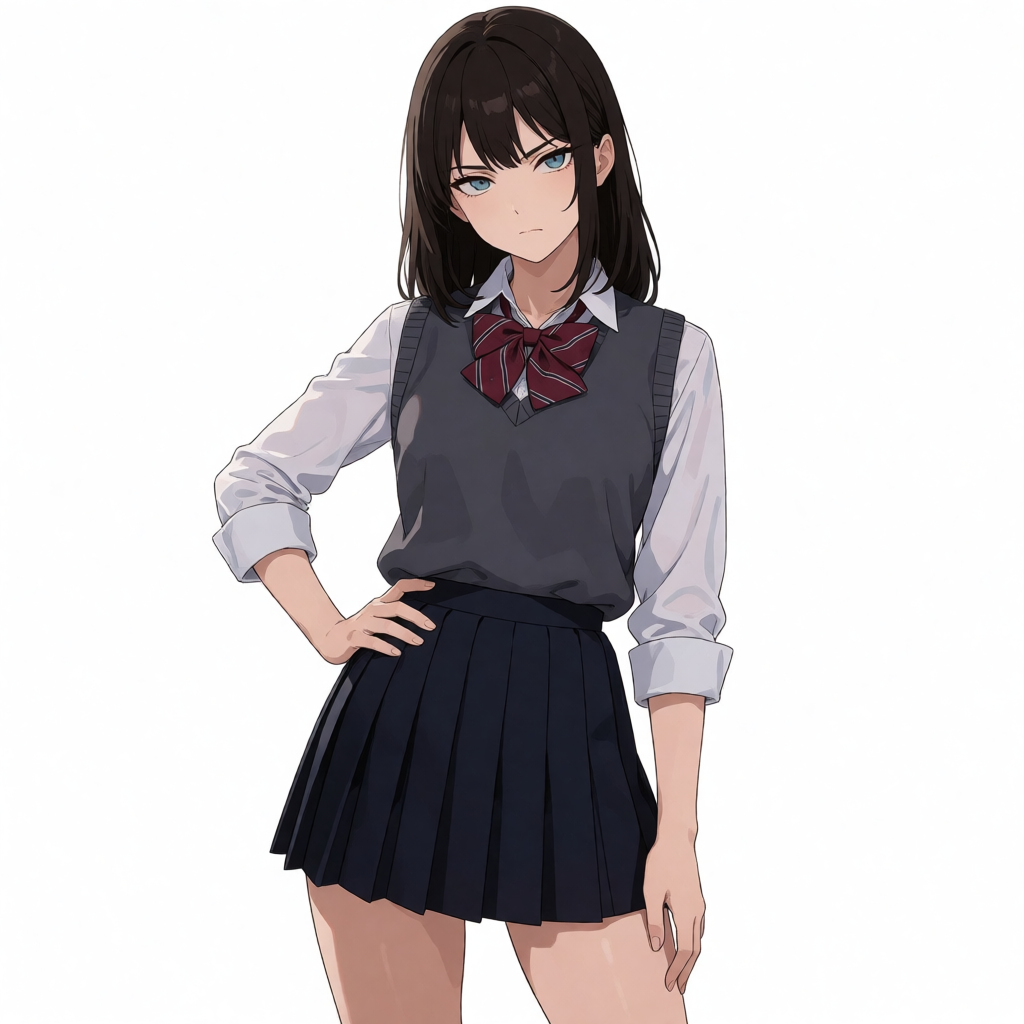
で、これの手をQwen 2.1で動かしてみましょう。
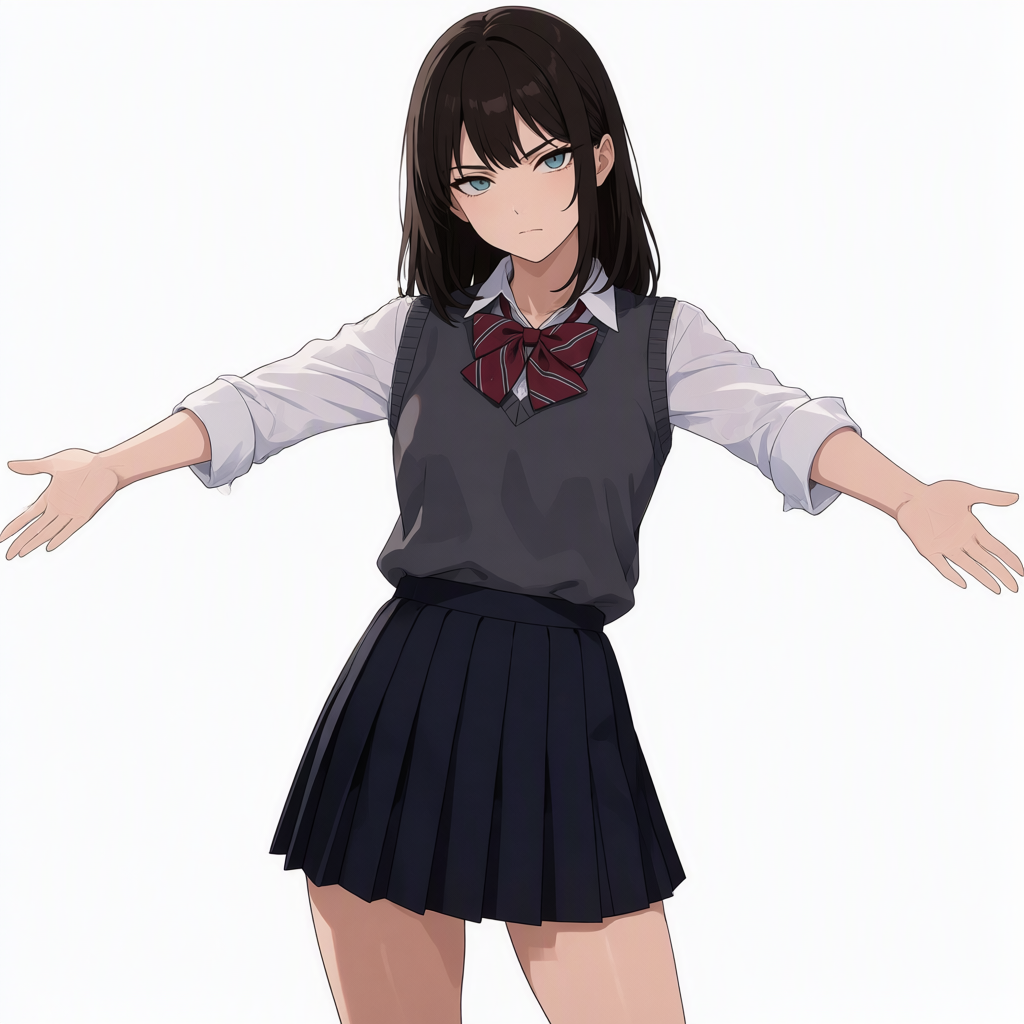
シャツの袖の下側と左モモの影が少し不自然で、指の描写がやや凡庸ですが、指示はわりときちんと通ります。この使い方がベターですかね。
全体的にQqen Image 2.1のアニメ画の描写はソフトタッチでフラットになるように思えます。透過機能が原因でしょうか?
とすると、写実の絵の方が向く?
ドット絵は劣化
ぼくの趣味のドット絵の作成を両モデルにさせましょう。
“pixel art,dragon,agressive posing, game asset,authentic game sprite,legible”
まずはQwen Image 2.1の結果です。
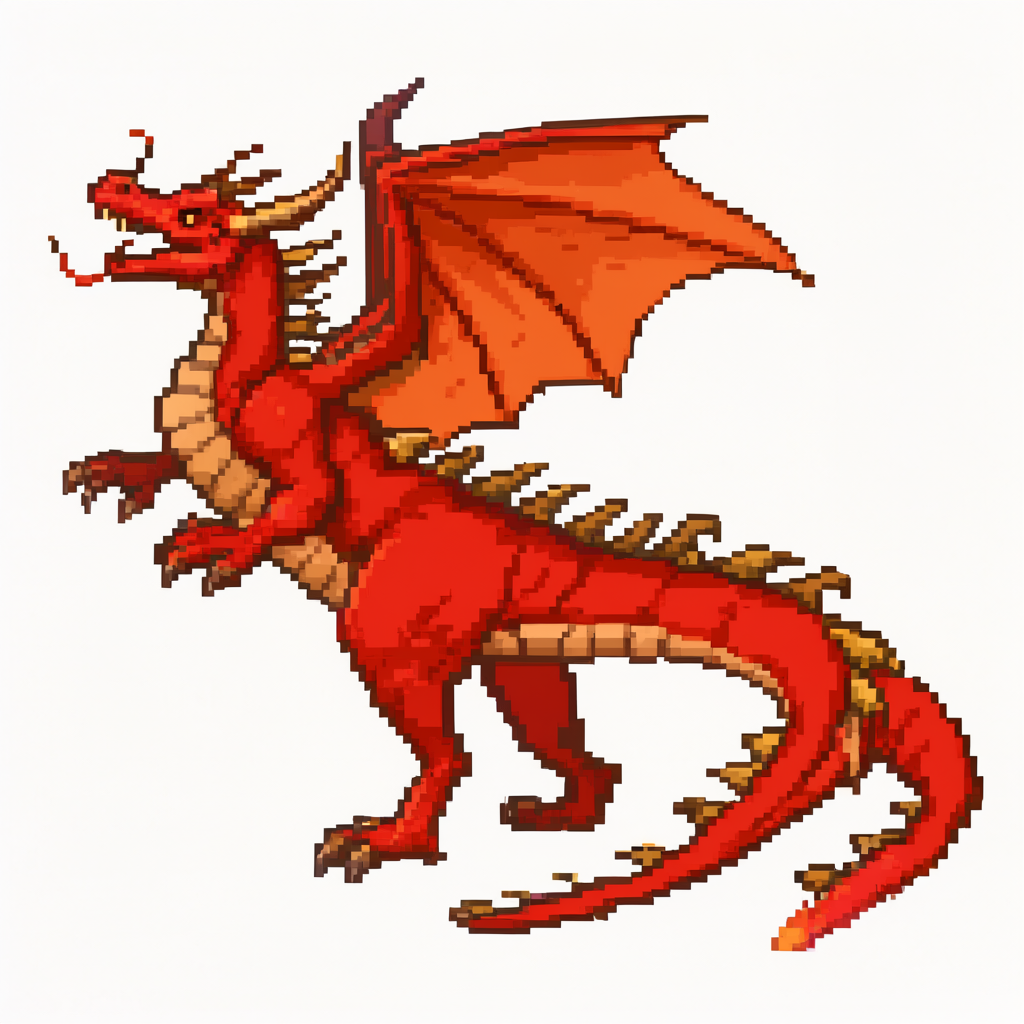
うーむ、初期のSNESテイストです。とにかく90年代のスクエア、エニックス、カプコン、任天堂、そして、SNKレベルではない。2512より2511のドット絵画風に似ます。
こちらはKrea2のエルフの結果です。
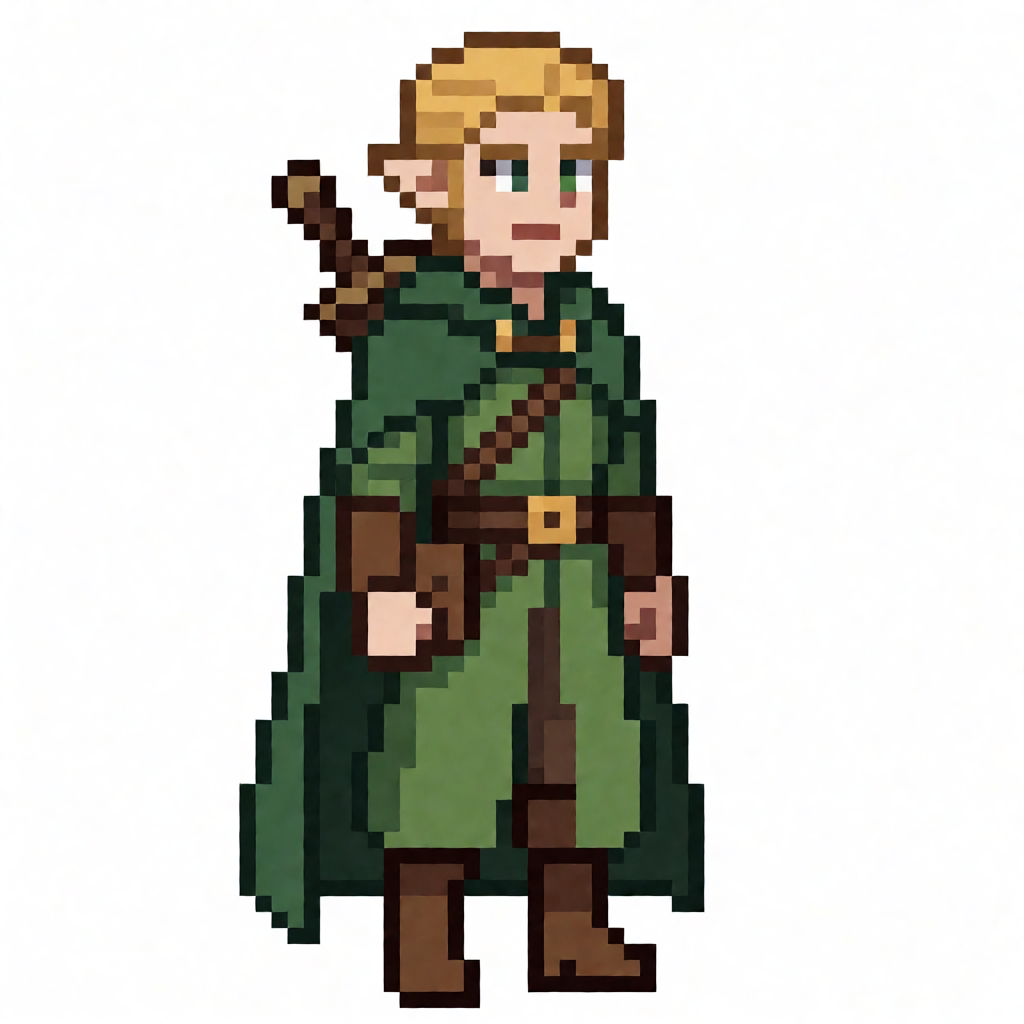
GBA風? 悪くありません。フィールドのアバター絵には十分でしょう。
ドラゴンはこんなかんじです。
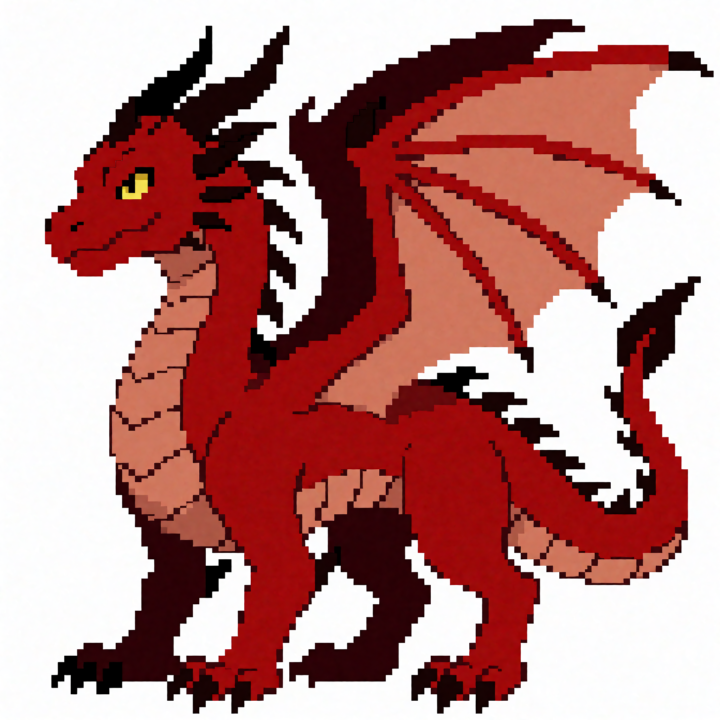
フラットな感じで出ます。ストゼロ以降のカプコン絵っぽいスタイルか。
一方、Qwen2512の出力です。フェニックスの絵。加工なしの出力のママ。
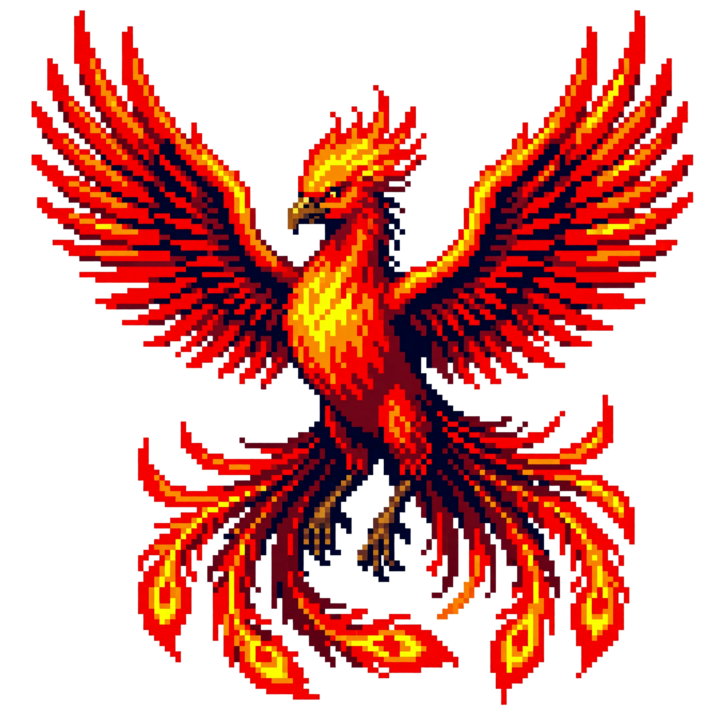
なぜかこいつだけが異常なごりごりのクオリティのものを吐き出します。ロマサガ3とかメタスラ3とか、あの辺のごりゅんごりゅんの鬼ドット絵。設定の差か? うーん。
ということで、ごりごりのドット絵作成には2512かSprite Fusionのクラウド版をおすすめします。
Qwen Image 2.1まとめ
- 透過色と修正機能に対応
- 速度は普通
- 絵柄はさほど変わらず
- ドット絵は劣化
- Apache 2.0じゃない ※要注意
1モデルで新規作成から修正までできて、透過色を扱えるそこそこの速度のオープンウェイトモデルというのが9カ月ぶりのQwenの新作の所感です。個人的に若干の期待外れ感を感じます。
あと、生成物の商用利用の可否がイマイチ謎です。OK説とNG説がある。どっち? Apache 2.0でないのはたしかですが。これも躊躇の原因の一つ。
ぼくはKrea2と2512を使うかな・・・どのみち、仕上げにはPhotoshopやAsepriteを使いますから、わざわざAIモデルで修正する必要性を感じません。
あと、Pixel Snapperの開発元のSprite Fusionのウェブ版が少し前に大幅アップデートされました。ドット絵、ドット絵の修正、ドット絵のアニメーションが可能です。
ただし、上位機能にはログインとサブスクが必要です。
